De cero a un
framework completo.
Web, APIs, mobile y CI/CD. Experiencia como QA Architect y QA Lead en VASS.
Ver trayectoriaSENIOR QA AUTOMATION ENGINEER
Soy Gonzalo. Construyo frameworks de testing desde cero y herramientas de IA para equipos que necesitan confiar en su software.
EXPERIENCIA EN EQUIPOS DE
Web, APIs, mobile y CI/CD. Experiencia como QA Architect y QA Lead en VASS.
Ver trayectoriaEvaluación de LLMs, sistemas RAG, regresión de prompts y seguridad.
Explorar AI Testing LabAutor del Manual de QA para Sistemas de IA. 193 páginas de referencia práctica.
Conocer el manual01 — TRAYECTORIA
De entender el negocio a diseñar la estrategia de calidad. Una trayectoria en banca, telecomunicaciones, retail y ciberseguridad.
Automatización.
Arquitectura.
Inteligencia artificial.
Cliente: DIA Group · Retail · Sep 2025 – Actualidad
Ciberseguridad SaaS · Sep 2022 – Ago 2025
Planificación e implementación de tests E2E y de integración con Cucumber + REST Assured + Java. Construí herramientas QA basadas en LLMs (generación de tests desde Jira/Xray, análisis de fallos desde reportes JUnit/Cucumber) integradas en pipelines GitLab CI. Performance con JMeter, seguridad con OWASP ZAP. Métricas y dashboards de QA (cobertura, tasa de éxito, defectos por severidad). Proyectos cross-funcionales con Playwright. Web test executor con HTML/CSS/JS para ejecutar y monitorizar tests con logs en tiempo real.
Clientes: Prosegur, Redsys y Bankinter · Jul 2019 – Sep 2022
Diseñé e implementé un framework de QA completo desde cero (Robot Framework para web/mobile/REST API) integrado en Jenkins y Azure DevOps. Pruebas de carga y estrés con JMeter sobre HTTP/API, Azure Service Bus y MQTT. Monitorización con Azure Application Insights y Grafana, traduciendo métricas en recomendaciones para stakeholders. Desarrollo del producto interno QAWAT (Quality Assurance Web Application Testing) con demos a clientes potenciales. En Bankinter: automatización API/web (Postman/Newman, Katalon) y testing PSD2 en Agile/Scrum.
A través de MTP · Telecomunicaciones · Dic 2018 – Jul 2019
Automatización API y web con Postman/Newman, Katalon y Selenium, integrada en pipelines CI con Jenkins. Diseño de generadores de datos de test basados en API y creación de tests de carga con JMeter. Testing E2E y de integración en entorno Agile.
Clientes: BBVA y DGT · Abr 2016 – Dic 2018
En BBVA: testing funcional y automatizado con framework interno Java/Selenium, aplicando BDD (Cucumber/Gherkin) en squads Agile, gestión de defectos, testing de integración y soporte en entornos Linux. Antes en DGT: testing funcional manual y automatizado con UFT, diseño de casos de test y gestión de defectos con TestLink/Mantis.
BNP Paribas · Servicios financieros · Jul 2014 – Mar 2016
Tres etapas formativas: Compliance (cumplimiento normativo y control), coordinación entre IT y Producto , y la oficina de proyectos (gestión y coordinación). Primer contacto profundo con el mundo IT antes de especializarme en QA.
02 — TRABAJO SELECCIONADO
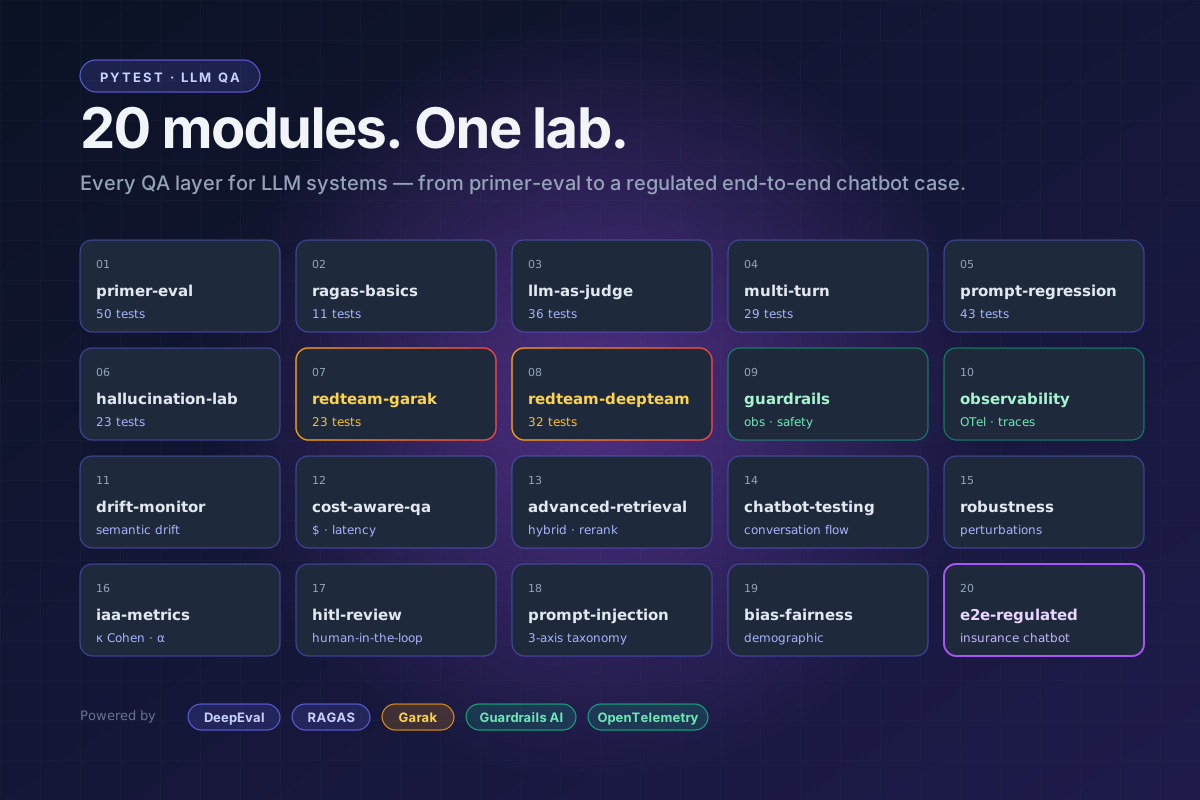
De un primer test de LLM a un caso end-to-end de chatbot regulado, con incidente, runbook y postmortem.
Explorar el laboratorioEn LLMs y RAG, la calidad también implica seguridad, consistencia, recuperación de contexto y capacidad de investigar fallos.
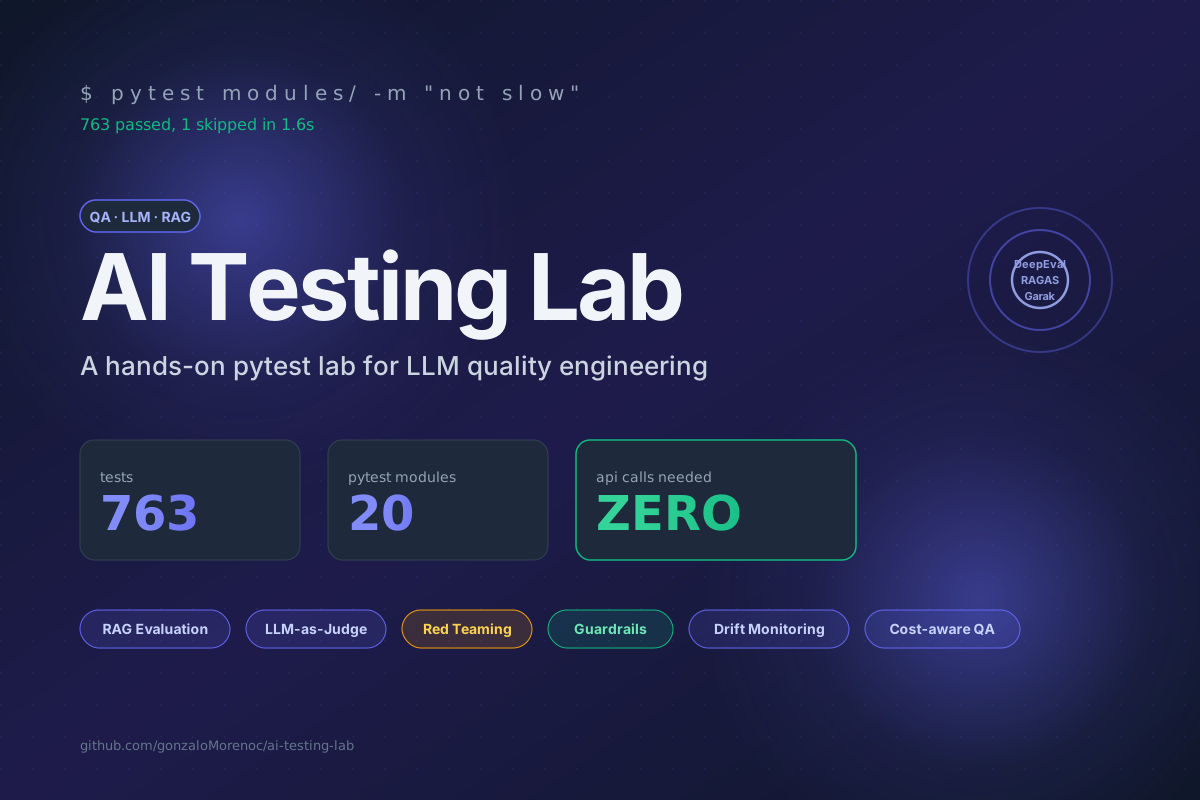
Un laboratorio modular en pytest que reúne DeepEval, RAGAS, Garak, Guardrails AI y OpenTelemetry con un caso de extremo a extremo.
763 tests organizados en 20 módulos independientes. Código y ejemplos disponibles para revisar cómo se plantean las pruebas y qué cubre cada módulo.
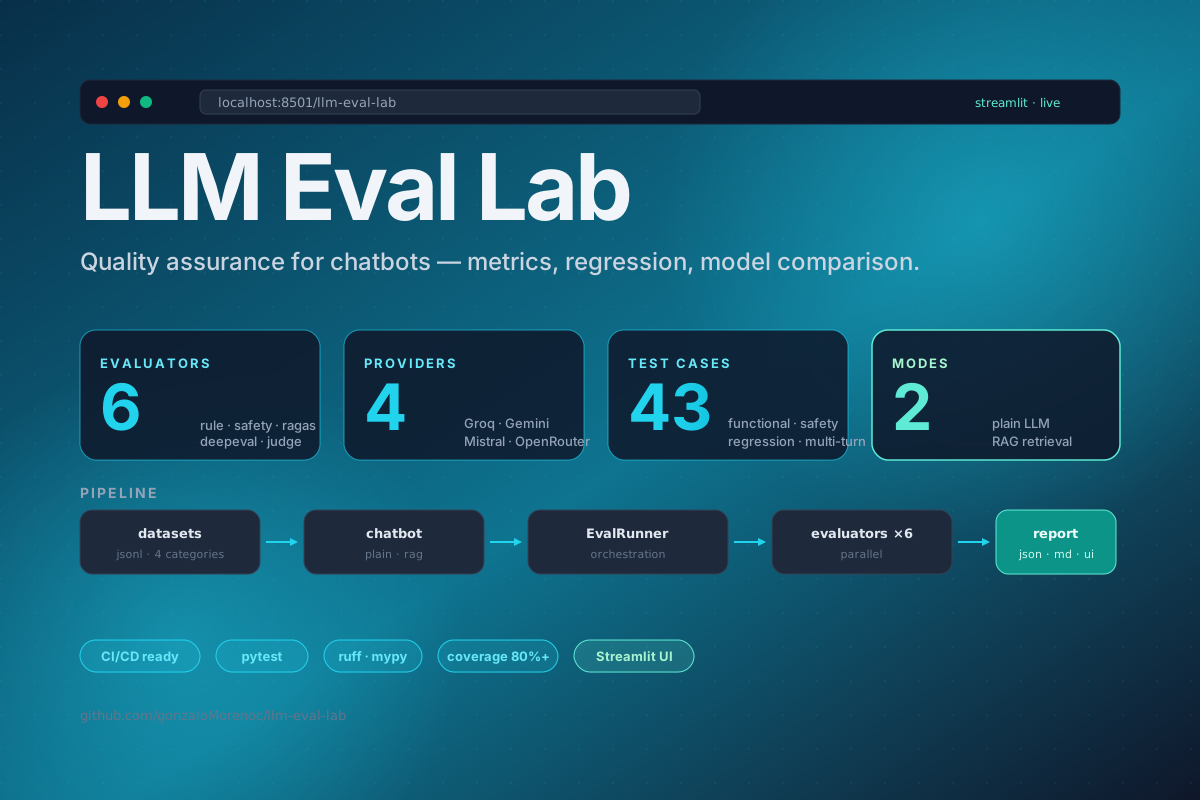
Abrir repositorioEvaluación de chatbots con seis evaluadores, modos plain y RAG, y un dashboard interactivo.
Python · RAGAS · DeepEval · Streamlit CASO 03 / IA APLICADA A QAMemoria operativa de QA: conecta conocimiento del proyecto, triaje de fallos y planes de prueba, con actas de release firmadas y verificables.
FastAPI · Next.js · pgvector · OllamaEXPLORA EL CATÁLOGO
2026
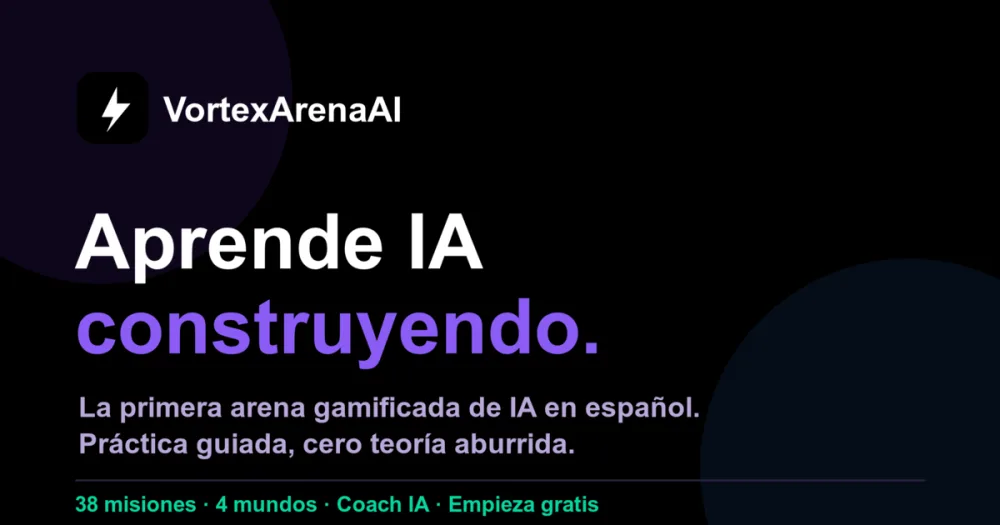
🎮 58 misiones · 4 mundos · Coach IA
Plataforma gamificada para aprender IA como un juego de rol: eliges tu rol, completas 58 misiones reales en 4 mundos, ganas XP, subes de nivel y compites en un ranking global. Un Coach IA evalúa las respuestas de texto libre con un LLM (Google Gemini) y da feedback inmediato; el veredicto (passed/score/XP) se calcula en el servidor con Supabase Edge Functions, así que las respuestas correctas nunca se filtran al cliente. Incluye repaso espaciado (SRS), meta diaria, sistema de energía, logros, rachas y certificados verificables públicamente.
2026
Memoria de QA · Triaje · Evidencia verificable
Plataforma de memoria operativa de QA que conecta conocimiento del proyecto, fallos, tests y CI. Incluye triaje de fallos, planes de prueba basados en la memoria, onboarding, generación de automatización y actas de release firmadas con Ed25519 y verificables. Embeddings locales, Ollama por defecto y revisión humana para las propuestas de cambio. Evolución de SmartErrorDebugger.
2025
🧪 763 tests QA de LLM · 0 llamadas API
Laboratorio práctico en pytest que cubre todas las capas de QA para sistemas LLM — desde tu primer LLMTestCase hasta un caso end-to-end de chatbot regulado con incidente, runbook y postmortem. 763 tests en 20 módulos independientes, basado en DeepEval, RAGAS, Garak, Guardrails AI y OpenTelemetry. Sin API key para ejecutar la suite completa.
2025
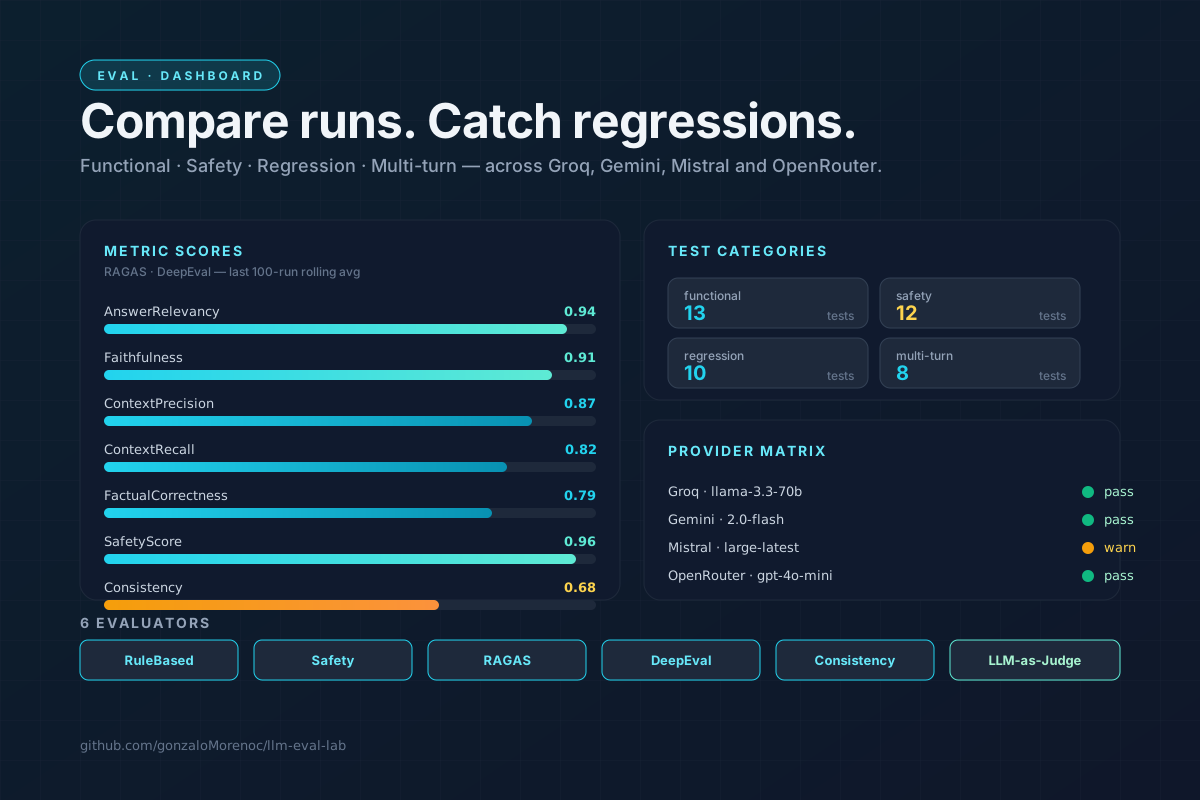
📊 6 evaluadores · 4 proveedores LLM
Framework QA completo para evaluar chatbots IA. Combina 6 evaluadores (rule-based, safety, RAGAS, DeepEval, consistency, LLM-as-judge) sobre Groq, Gemini, Mistral y OpenRouter. 43 test cases en categorías funcional, safety, regression y multi-turn, modos plain y RAG, dashboard interactivo en Streamlit y CI/CD con lint, type check y cobertura.
2025
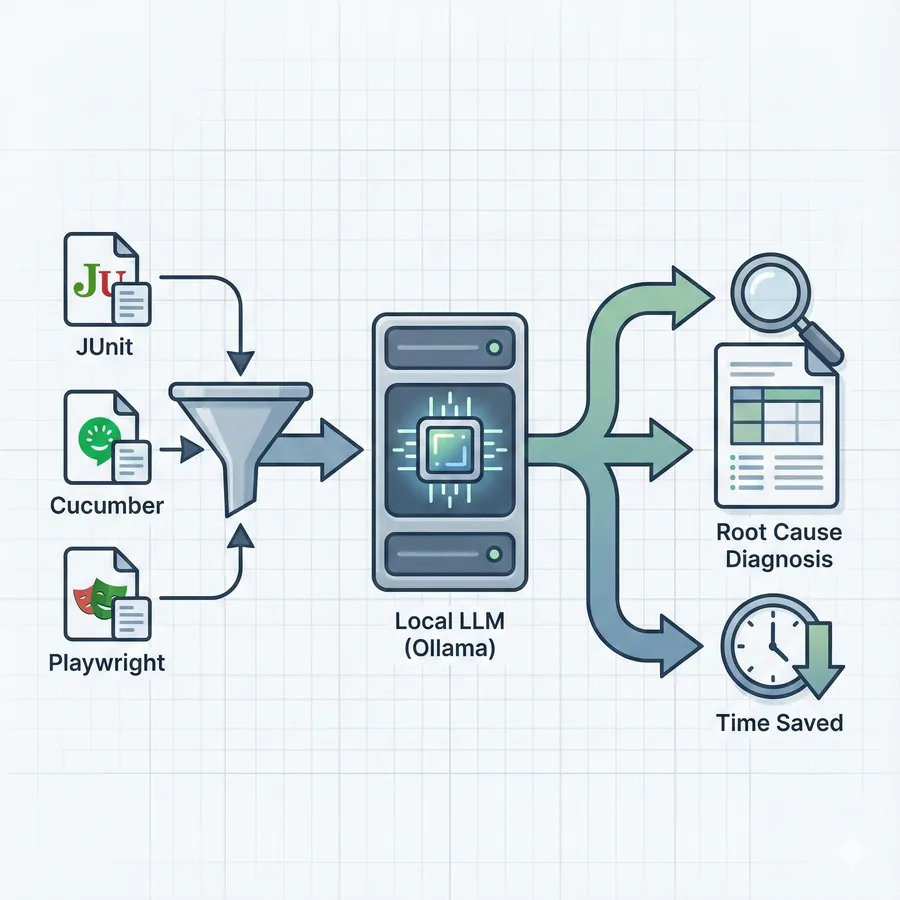
⚡️ Reduce tiempo de triage un 60%
Framework construido con LLMs en local con Ollama con el objetivo de analizar reportes JUnit/Cucumber/Playwright y diagnostica automáticamente la causa raíz de los fallos. El objetivo es ahorrar tiempo en el análisis de los errores en las ejecuciones de tests automáticos.
2024
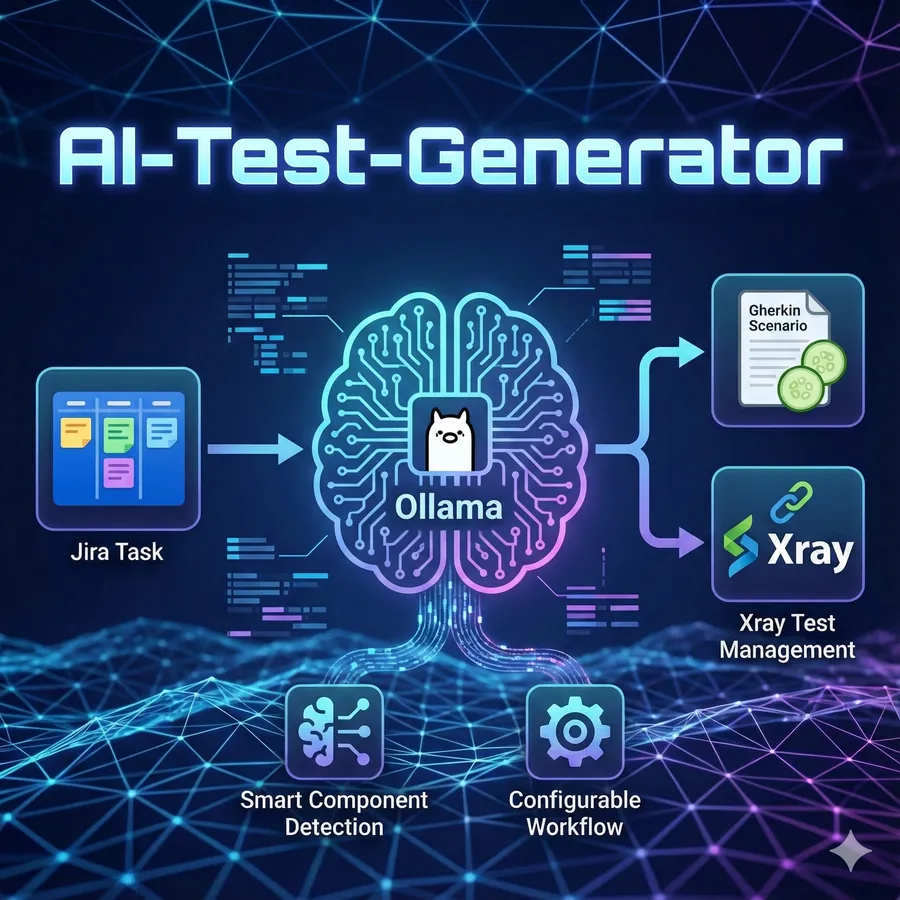
🕒 -70% Esfuerzo Definición de Tests
Generador automático de tests en formato Gherkin. Esta herramienta analiza las historias de usuario o tareas de jira del sprint o el backlog y mediante un modelo de IA en local con Ollama genera los tests y los sube a jira xRay.
2024
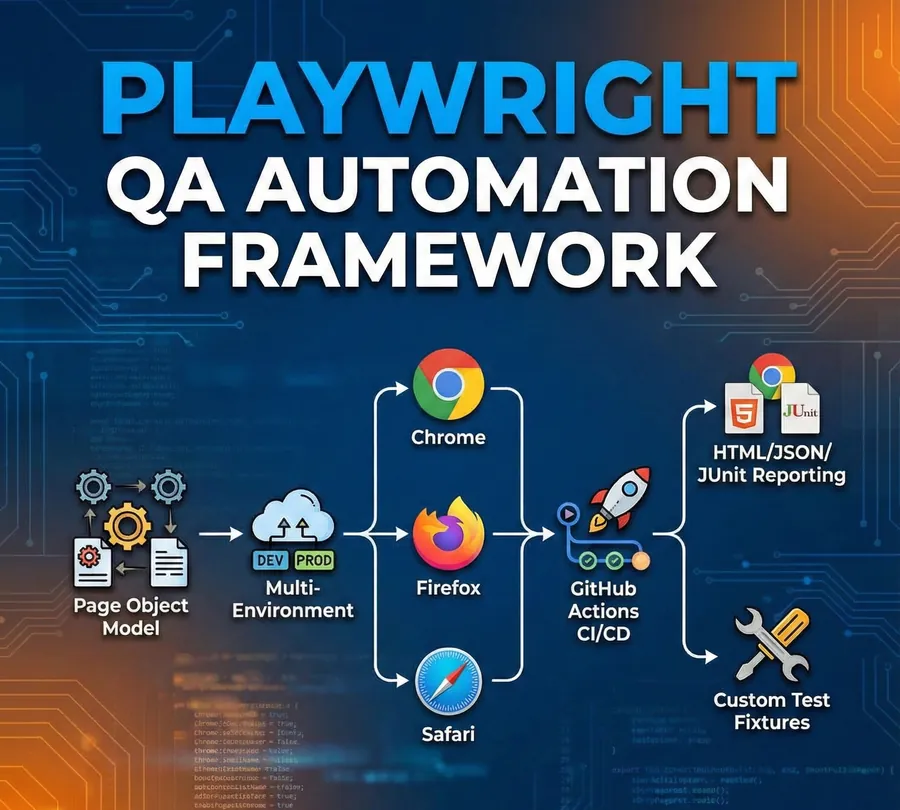
🛡 Arquitectura Zero-Flakiness
Framework E2E modular diseñado para escalabilidad. Incluye abstracciones de patrones, lógica de reintentos y ejecución Dockerizada.
2024
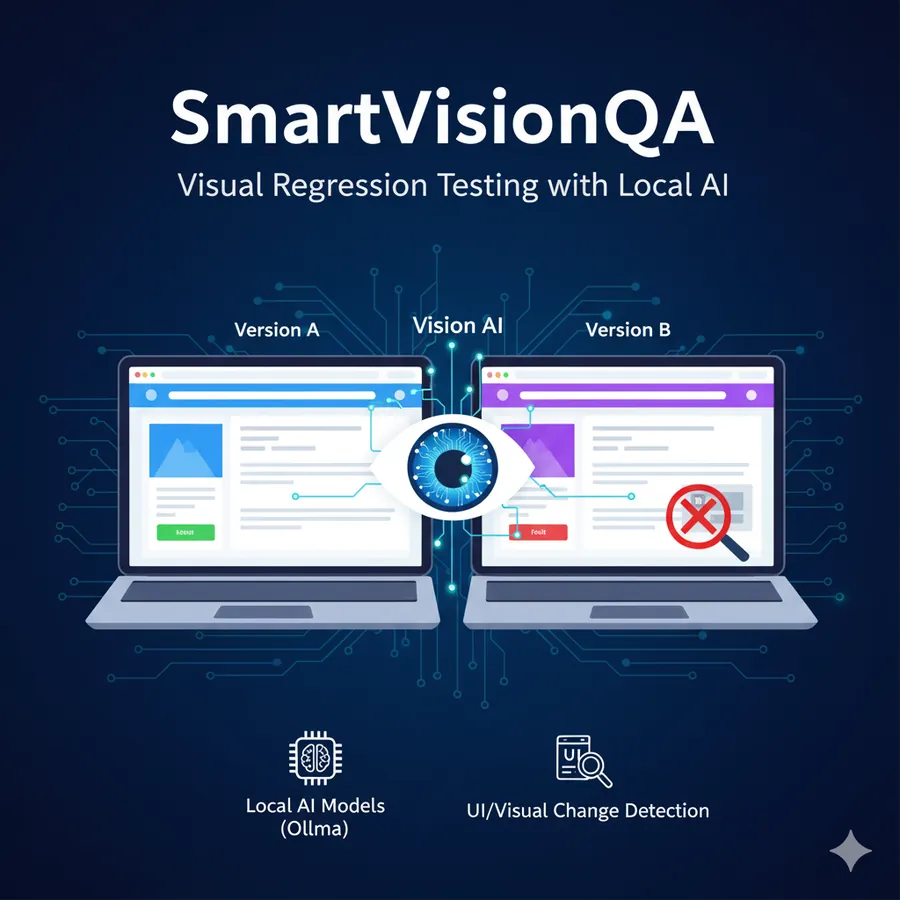
👁 Validación Pixel-Perfect
Herramienta en Python que utiliza IA en local con Ollama para detectar cambios visuales entre distintas versiones de una web. El objetivo es explorar cómo la automatización de QA puede apoyarse en modelos ligeros de visión para identificar cambios en la interfaz, colores, texto o estructura visual.
2024
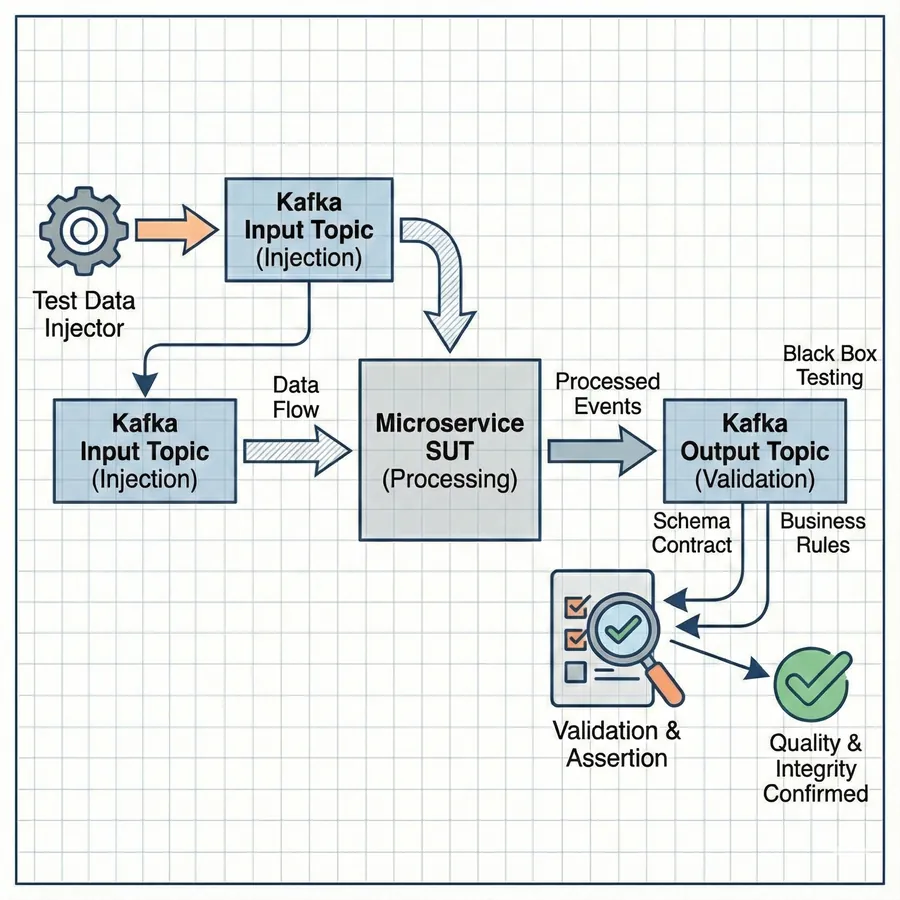
Este proyecto implementa un framework de pruebas automatizadas diseñado para validar arquitecturas orientadas a eventos (Event-Driven Architectures) basadas en Apache Kafka.
Este proyecto implementa un framework de pruebas automatizadas diseñado para validar arquitecturas orientadas a eventos (Event-Driven Architectures) basadas en Apache Kafka. El objetivo principal es asegurar la integridad, transformación y calidad de los datos que fluyen a través de pipelines de datos asíncronos.
2024
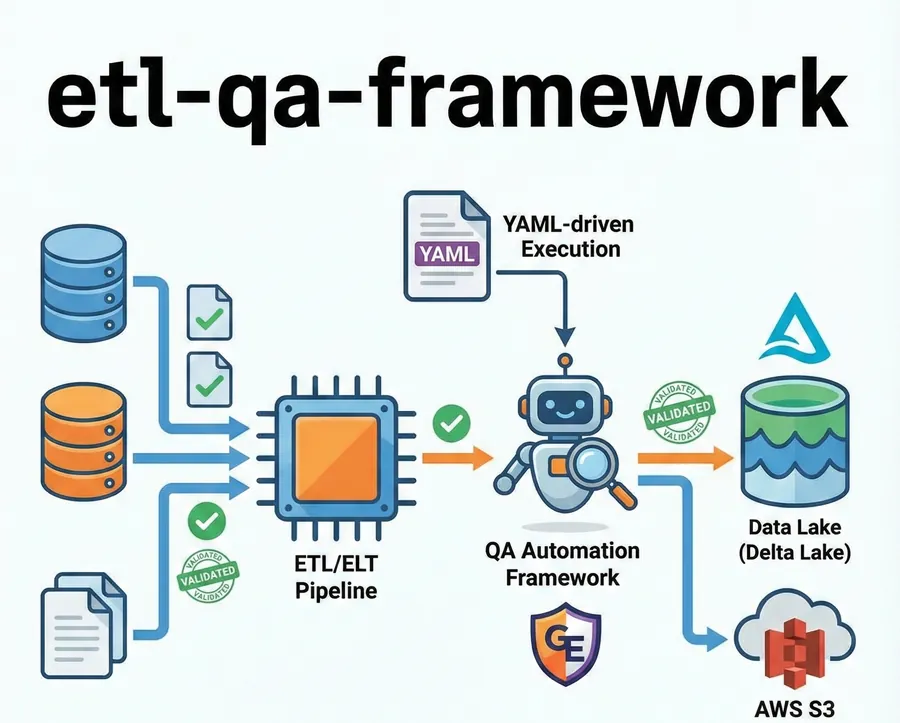
Un framework de automatización de QA centrado en datos para validar pipelines ETL/ELT en entornos Big Data, garantizando la integridad y calidad de extremo a extremo mediante ejecución basada en YAML, validaciones con Great Expectations y componentes preparados para la nube como AWS S3 y Delta Lake..
Un framework de automatización de QA centrado en datos para validar pipelines ETL/ELT en entornos Big Data, garantizando la integridad y calidad de extremo a extremo mediante ejecución basada en YAML, validaciones con Great Expectations y componentes preparados para la nube como AWS S3 y Delta Lake.
2024
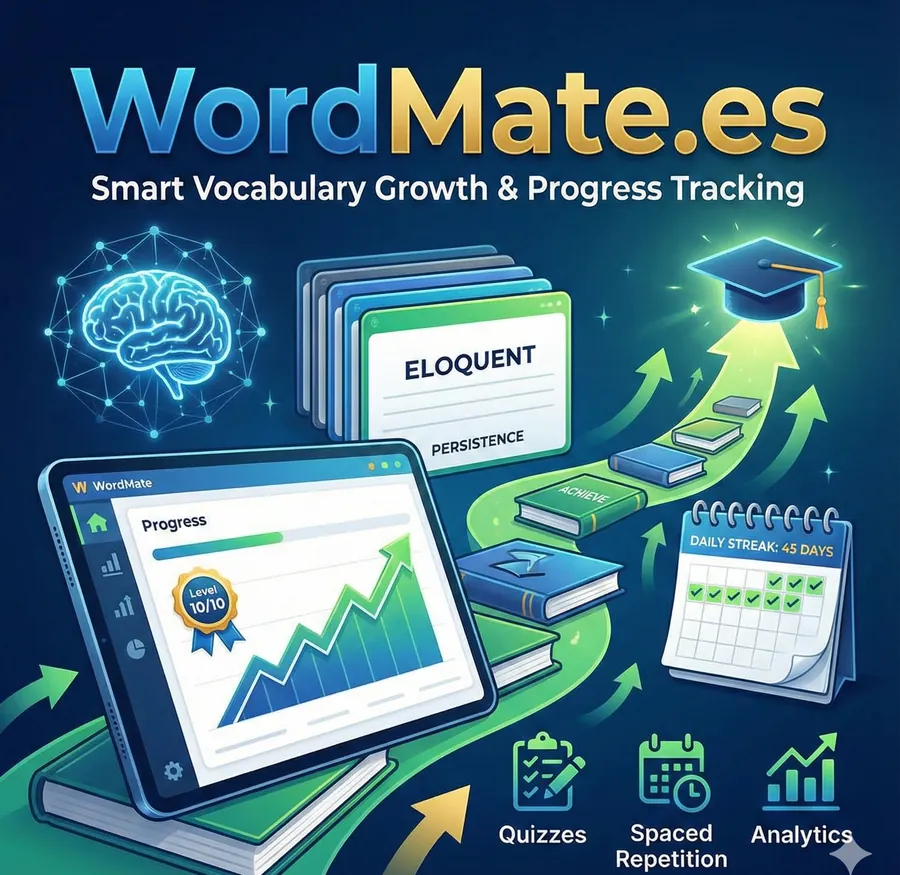
Plataforma full-stack con rutas de estudio potenciadas por IA
WordMate es una plataforma inteligente para aprender inglés centrada en ampliar vocabulario y medir el progreso real. Incluye rutas personalizadas, listas de vocabulario propias, tarjetas, quizzes y un panel de analíticas claro. Con práctica de repetición espaciada, rachas diarias y un sistema de progresión de 10 niveles, WordMate ayuda a mejorar el vocabulario de forma sencilla y motivadora.
2023
Framework de automatización de pruebas de API REST con Cucumber BDD, Rest Assured y Java.
Framework de automatización de pruebas de API REST con Cucumber BDD, Rest Assured y Java. Incluye pruebas CRUD completas, integración CI/CD y compatibilidad con múltiples entornos.
2023
📋 Cobertura API contract-first
Suite de pruebas API contract-first con Karate DSL para validar endpoints REST en flujos de autenticación, manejo de errores e integridad de datos. Cubre escenarios CRUD con scenario outlines, ejecución paralela y reporting HTML integrado. Integrado en CI con Maven.
2023
⚡ Regresiones de latencia detectadas en CI
Suite de pruebas de carga y estrés con Apache JMeter para APIs REST y flujos web. Incluye configuraciones de thread groups para escenarios de ramp-up, soak y spike, con assertions de umbral integradas en CI para bloquear builds ante regresiones de latencia.
2023
🔄 Cero ciclos de regresión manual
Suite E2E con Playwright y TypeScript integrada en un pipeline declarativo de Jenkins. Ejecuta pruebas cross-browser en Chromium, Firefox y WebKit en paralelo, genera reportes Allure en cada build y bloquea merges cuando la cobertura cae por debajo del umbral.
2022
Framework robusto de Selenium WebDriver con Java, implementando Page Object Model y TestNG..
Framework robusto de Selenium WebDriver con Java, implementando Page Object Model y TestNG.
2022
Framework de pruebas de carga con Locust para performance y estrés..
Framework de pruebas de carga con Locust para performance y estrés.
2022
Suite de pruebas API construida con Robot Framework, con enfoque keyword-driven..
Suite de pruebas API construida con Robot Framework, con enfoque keyword-driven.
No hay proyectos que coincidan con tu búsqueda.
03 — PUBLICACIÓN
Manual de QA para Sistemas de Inteligencia Artificial
LLMs, RAG, chatbots y agentes. Una guía de referencia profesional sobre evaluación, seguridad, quality gates y observabilidad.
Contenido del manual en español · 4 apéndices
Antes de hablar de cómo testar IA, hace falta acordar de qué estamos hablando. La inteligencia artificial es la rama de la informática que construye sistemas capaces de hacer tareas que antes solo hacían las personas: entender lenguaje, reconocer objetos, planificar acciones o generar contenido nuevo. Russell & Norvig (2021), en el manual de referencia Artificial Intelligence: A Modern Approach (4ª ed.), articulan la definición canónica del campo en torno a la idea de un agente que actúa racionalmente para maximizar el valor esperado de un objetivo dado.
Esa definición es útil pero abstracta. Para QA conviene una definición operativa, que sirva para decidir si lo que tenemos delante es «software de toda la vida» o «software de IA»:
IA es cualquier sistema cuyo comportamiento se aprende de datos, en lugar de programarse línea a línea con reglas.
Esa diferencia — comportamiento aprendido en lugar de programado — es la que rompe los pilares del QA clásico. En software tradicional, el código siempre devuelve lo mismo ante la misma entrada, así que tiene sentido hablar de cobertura de ramas, oráculo de tests por igualdad exacta y regresión comparando byte a byte. En IA, la misma entrada puede dar respuestas distintas, el oráculo «correcto» no siempre existe, y la regresión se mide en distribuciones. El resto del manual explica cómo se adapta el QA a esa nueva realidad.
Cuando se habla de «IA» en prensa se mezclan tres niveles muy distintos. Conviene tenerlos separados:
No toda IA es IA generativa. En un sistema real conviven cuatro familias o paradigmas, cada uno con su forma de funcionar y sus implicaciones para QA. La tabla siguiente las sitúa de menor a mayor complejidad estadística:
| Paradigma | Cómo funciona | Ejemplo | Implicación QA |
|---|---|---|---|
| IA simbólica | Reglas lógicas explícitas | Safety filter declarativo, allowlist de tools | Tests basados en reglas (software clásico) |
| ML clásico | Aprendizaje a partir de features ingenierizadas | Classifier de intent, detector PII | Métricas estadísticas (accuracy, precision, recall) |
| Deep learning | Redes neuronales que aprenden representaciones | CNN imagen, RNN texto | Métricas estadísticas + análisis por subgrupo |
| Generative AI | Modelos que generan contenido nuevo | LLM, modelo de difusión, multimodal | Métricas semánticas, faithfulness, robustness |
En 2026, la mayoría de sistemas conversacionales en producción son IA generativa basada en arquitecturas transformer (el motor detrás de ChatGPT, Claude o Gemini). La IA simbólica no ha desaparecido: sigue viva en guardrails declarativos, validación de esquemas JSON y motores de reglas de negocio. Un sistema QA maduro testa los dos paradigmas con métricas distintas; los capítulos siguientes lo desarrollan.
Dentro del aprendizaje automático (machine learning, ML) hay varias formas de aprender, y cada una se mide con métricas distintas. Saber qué tipo de aprendizaje usa el subsistema bajo test es lo que decide si vale más medir con precision/recall, con perplexity o con win-rate. Los cinco tipos canónicos son:
| Tipo | Qué aprende | Ejemplo en QA AI | Métrica típica |
|---|---|---|---|
| Supervised | Mapeo input → label etiquetado | Classifier de intent; detector de PII | Precision, recall, F1 |
| Unsupervised | Estructura latente sin etiquetas | Clustering de queries | Silhouette, ARI |
| Semi-supervised | Etiquetas escasas + pools no etiquetados | Bootstrap de golden dataset | Métrica supervisada sobre validación |
| Self-supervised | Etiquetas derivadas del propio input | Pre-training de LLMs (next-token prediction) | Perplexity, downstream eval |
| Reinforcement | Política por recompensa | RLHF para alineación | Reward model score, win-rate |
Un detalle clave: un LLM moderno no usa un solo tipo de aprendizaje, sino los tres últimos en cadena. Primero aprende lenguaje de forma self-supervised (pre-training); luego se le enseña a seguir instrucciones de forma supervised (instruction tuning); finalmente se ajusta por refuerzo con feedback humano (RLHF, DPO o RLAIF). El §2.5 del Cap. 2 desarrolla cada etapa y por qué cada una abre modos de fallo distintos.
Dentro de la IA hay dos grandes formas de plantear un problema: discriminar (elegir entre opciones conocidas) y generar (producir contenido nuevo). Un clasificador de spam discrimina entre «spam / no spam»; un LLM como GPT-4 genera texto que antes no existía. La diferencia parece sutil pero cambia por completo cómo se testa el sistema, porque cambia el oráculo: en discriminativo hay una respuesta «correcta»; en generativo hay infinitas respuestas válidas.
| Aspecto | Discriminativo | Generativo |
|---|---|---|
| Qué modela | P(label | input) | P(output | input), muestreando |
| Output típico | Clase, score, valor numérico | Texto, imagen, audio, secuencia |
| Determinismo | Alto con threshold fijo | Bajo por naturaleza |
| Oráculo de test | Etiqueta esperada | Criterio semántico (similitud, faithfulness) |
| Métricas | Confusion matrix, ROC/AUC, F1 | RAGAS, LLM-as-Judge, embedding similarity |
| Coste por inferencia | Bajo | Medio a alto |
En la práctica, los sistemas reales combinan los dos enfoques. Un chatbot RAG típico tiene cuatro componentes encadenados: un clasificador de intent (discriminativo, decide a qué se refiere la pregunta), un filtro de safety (discriminativo, decide si la pregunta es legítima), un retriever que ordena los documentos más relevantes (ranking discriminativo) y, al final, un LLM generativo que produce la respuesta. Cada uno se testa con su propia métrica.
La IA generativa no es solo «chatbots de texto». Cada modalidad (texto, código, imagen, audio, vídeo, multimodal) tiene sus casos de uso típicos, sus modelos de referencia y, sobre todo, sus tests específicos. Este manual cubre principalmente texto, pero conocer el resto del panorama ayuda a situar los proyectos en los que vas a trabajar:
| Modalidad | Tareas | Ejemplos | Tests específicos |
|---|---|---|---|
| Texto | Q&A, resumen, redacción, código | GPT-4o, Claude Sonnet 4.x, Llama 3/4, Mistral, Qwen | Faithfulness, factual accuracy, robustness |
| Código | Autocompletado, refactor | Copilot, Cursor, Codeium | Compilable, tests pasan, sin vulnerabilidades |
| Imagen | Text-to-image, edición | DALL·E 3, Stable Diffusion, Midjourney | Adherencia a prompt, NSFW, watermarking |
| Audio | TTS, STT, generación | Whisper, ElevenLabs, OpenVoice | WER, MOS, latencia TTFT |
| Vídeo | Generación, edición | Sora, Veo, Runway | Coherencia temporal, fidelidad |
| Multimodal | Texto + imagen + audio | GPT-4o, Claude Sonnet 4.x, Gemini 2 | Cross-modal grounding, cross-modal hallucination |
Este manual se centra en la modalidad texto / conversacional, que es la que más ha penetrado en producción empresarial. La multimodalidad se introduce en el §2.6 del Cap. 2, lo justo para situarla; un capítulo dedicado queda pendiente para futuras versiones.
Si vienes del mundo ISTQB es importante saber dónde encaja este manual respecto a las certificaciones existentes. El syllabus ISTQB tiene dos niveles relacionados con IA, y este manual se alinea sobre todo con el primero:
| Recurso | Audiencia | Enfoque |
|---|---|---|
| ISTQB Foundation Level | QA generalista | Software testing clásico |
| ISTQB CT-AI v1.0 | QA en transición a IA | Fundamentos AI; probar sistemas IA |
| ISTQB CT-GenAI v1.0 | QA con base CT-AI | Usar IA generativa para probar software (AI-augmented testing) |
| Manuales de proveedor | Equipos sobre un stack | Vendor-specific |
| Este manual | QA AI Engineer / SDET / AI Quality Engineer | Práctico; vertical LLMs / RAG / chatbots / agentes |
El cuerpo del manual recorre treinta y tres capítulos en orden secuencial. Sobre esa secuencia se superponen siete agrupaciones temáticas transversales que ayudan a localizar el material por área funcional. La agrupación es conceptual, no estructural: los capítulos siguen un orden de lectura lineal y las partes solo señalan «de qué trata cada bloque».
Los apéndices A-D aportan 45 preguntas de consolidación, referencias bibliográficas, índice alfabético y un caso práctico end-to-end.
114 páginas dan para mucho, pero no hace falta leerlas en orden estricto. Si vienes de QA clásico sin experiencia previa en ML o LLMs, la ruta más eficiente para llegar pronto a productivo es:
04 — PERFIL TÉCNICO
Testing, desarrollo y negocio conectados en una misma estrategia de calidad.
Consultar todas las tecnologías ↗
Playwright, Karate DSL, REST Assured,
Robot Framework, Selenium
Python, Java, TypeScript · GitLab CI,
Jenkins, Azure DevOps
ISTQB CTFL · CT-TAS · CT-MAT · CT-GenAI
Español nativo · Inglés intermedio
Senior QA Automation Engineer & SDET especializado en AI Quality Engineering , con foco en la evaluación de LLMs, chatbots y sistemas RAG. Diseño estrategias y suites de testing para validar calidad, seguridad, robustez y regresión en soluciones basadas en IA, incluyendo prompt regression, evaluación de respuestas y AI Red Teaming alineado con OWASP LLM Top 10. Llevo 10+ años llevando calidad a equipos de servicios financieros, telecomunicaciones, retail y ciberseguridad.
Certificado ISTQB CT-GenAI , CT-TAS, CT-MAT y CTFL. Construyo frameworks de automatización desde cero (Playwright, Karate DSL, REST Assured, Robot Framework, Selenium) integrados en pipelines GitLab CI / Jenkins / Azure DevOps. Mi diferencial: convertir la calidad en una capa de IA observable, evaluable y testeable, no en una checklist manual.
¿HABLAMOS?